- Insights, Stories & Events
- Bioprozessdaten Pharmaproduktion
Was tun mit Bioprozessdaten in der pharmazeutischen Entwicklung und kommerziellen Herstellung?
9 Min lesen
Als Verfahrensingenieur in der Verfahrensentwicklung oder Produktionswissenschaft sind Sie für die effiziente Entwicklung leistungsstarker Bioprozesse verantwortlich, sorgen für ein robustes Scale-up und stellen sicher, dass ein kommerzieller Prozess unter Kontrolle bleibt.
Höhepunkte
Merkblatt: Wie Sie das Beste aus Ihren Multifermenter-Daten herausholen
Erfahren Sie, wie PAS-X Savvy Ihnen hilft, Ambr®-Experimente so effizient wie möglich auszuwerten und die gesamte biopharmazeutische Prozessentwicklung zu beschleunigen.
Die Anforderungen an eine Best-Practice-Datenbank sind i) ein geeignetes Datenbankmodell zur Speicherung aller bioprozessrelevanten Daten in einer gemeinsamen Datenbank, ii) die Möglichkeit, Zeitreihendaten mit Metainformationen zu versehen (z. B. Prozessphasen und Ereignisse zu definieren), und iii) die Verwaltung von Datenvorverarbeitungsabläufen.
Mit seinem einzigartigen Datenmodell gleicht PAS-X Savvy alle Daten aus MES, ELN, LIMS, DCS, Historians, Data Lakes und Einzelgeräten ab, kontextualisiert sie und macht sie in einer einzigen Plattform verfügbar. Anpassbare Datenbankfilter helfen Ihnen, relevante Chargen, Vorgänge und Datentypen schnell zu identifizieren und Ihre eigenen Datensätze zu erstellen.
Nachdem alle Daten an einem Ort verfügbar sind, besteht die nächste Herausforderung darin, die richtige Visualisierungstechnik je nach Datentyp auszuwählen.
Daten visualisieren
Die Visualisierung ist das wichtigste Instrument zur Erkennung von Verarbeitungstrends und zur Untersuchung von Abweichungen. Um Trends schnell zu erkennen und die Ergebnisse zu melden, werden die Visualisierungen idealerweise direkt aus einer gemeinsamen Datenbank erstellt, ohne dass die Daten exportiert oder manuell in Tabellenkalkulationen bearbeitet werden müssen - was fehleranfällig ist und nicht empfohlen wird.
Jeder Datentyp erfordert unterschiedliche Visualisierungstechniken, wie z. B. mehrachsige Overlay-Diagramme zur Analyse von Verarbeitungstrends und Box-Plots/Histogramme zur Darstellung von Qualitäts- und Produktmerkmalen.
Häufig verwendete Visualisierungstools für Bioprozesse sind:
Mehrachsige Überlagerungsdiagramme
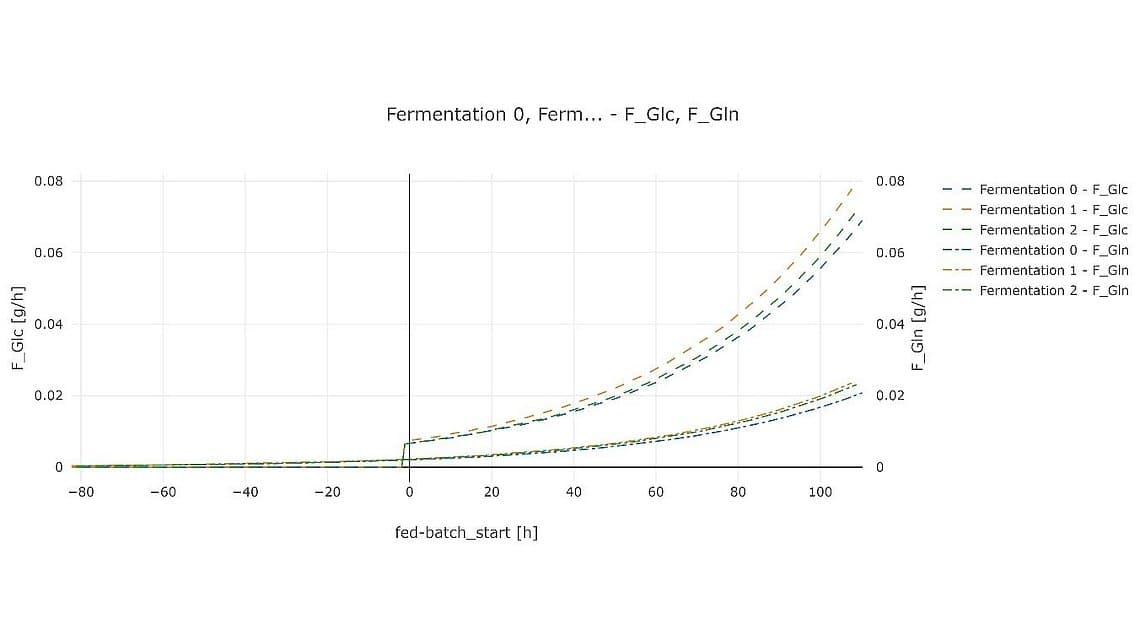
Damit lassen sich Zeitreihen (z. B. Fermentationsdaten, Chromatogramme usw.) mehrerer Herstellungs- und Entwicklungsläufe vergleichen. Um verschiedene Läufe vergleichbar zu machen, müssen die Zeitreihen zunächst an Ereignissen ausgerichtet werden (z. B. Zeitpunkt der Inokulation, Zeitpunkt der Elution). In einem zweiten Schritt können die Zeitreihen nach kategorischen Merkmalen gruppiert werden, was bereits eine einfache, aber sehr effektive visuelle Datenanalyse ermöglicht.
Balkendiagramme
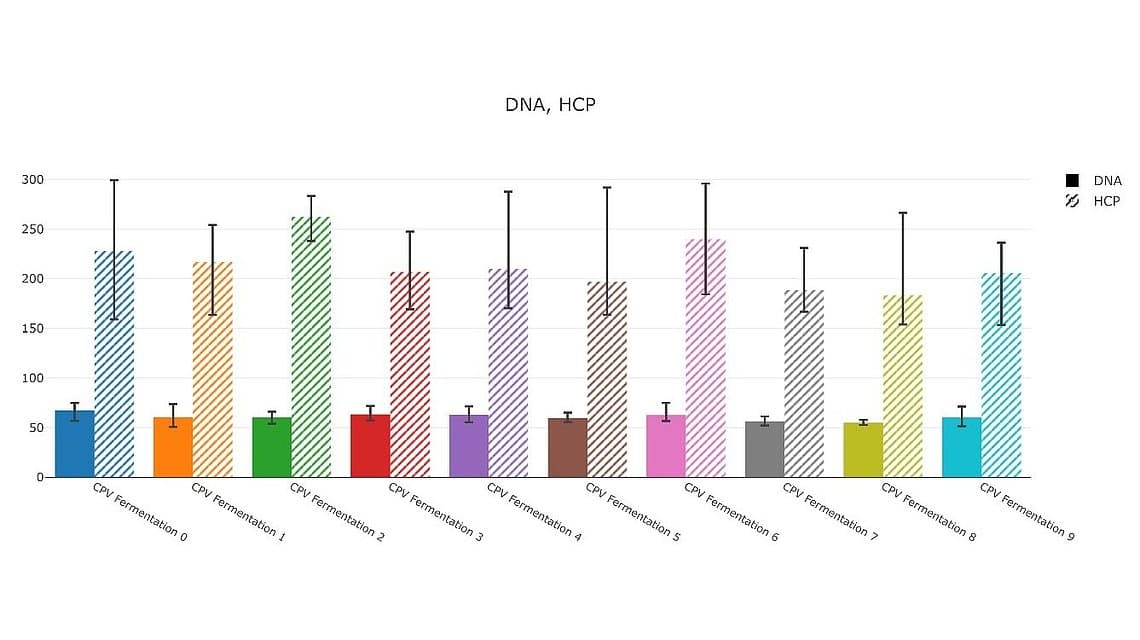
Visualisierung der Werte als Balken. Jeder Lauf wird als separater Balken dargestellt. Idealerweise kann die Unsicherheit um die Messwerte als Fehlerbalken dargestellt werden. Die Gruppierung der Balken nach einem kategorialen Merkmal ermöglicht eine einfache visuelle Datenanalyse.
Box-Plots
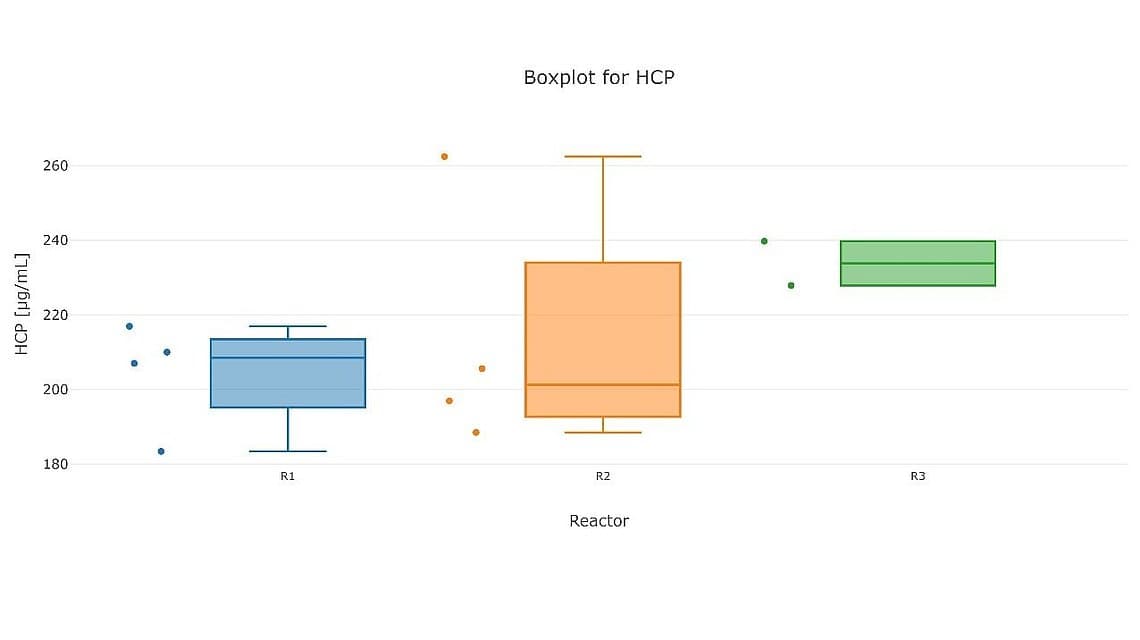
Eine Variable wird als Box dargestellt. Sie zeigt das Minimum, das Maximum, den Median der Stichprobe sowie das erste und dritte Quartil an. Anhand dieser Darstellung lässt sich erkennen, wie die Daten verteilt sind. Die Gruppierung nach kategorischen Merkmalen ermöglicht eine einfache visuelle Datenanalyse. Die Daten des angezeigten Merkmals werden dann auf der Grundlage der Stufen des kategorialen Merkmals in Gruppen unterteilt. Die Gruppen werden als separate Boxplots angezeigt.
Liniendiagramm/Trenddiagramm
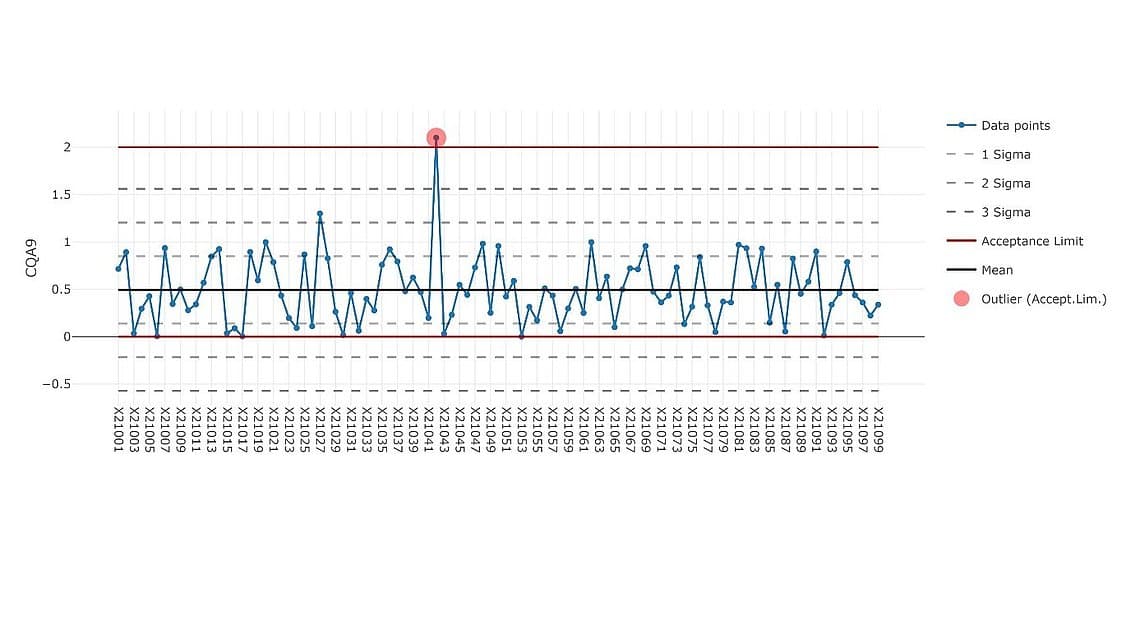
Numerische Merkmale werden als Linie in fortlaufender Reihenfolge dargestellt. Wird z. B. bei CPV-Trending zur Bewertung der Prozessrobustheit und zur Identifizierung von Trends verwendet.
Die Visualisierungs-App von PAS-X Savvy bietet Visualisierungstechniken für alle bioprozessrelevanten Datentypen und ermöglicht es Ihnen, Ihre Daten einfach darzustellen und auszurichten.
Häufig verwendete statistische Werkzeuge
Statistische Äquivalenztests: Verhält sich mein Prozess in verschiedenen Skalen ähnlich?
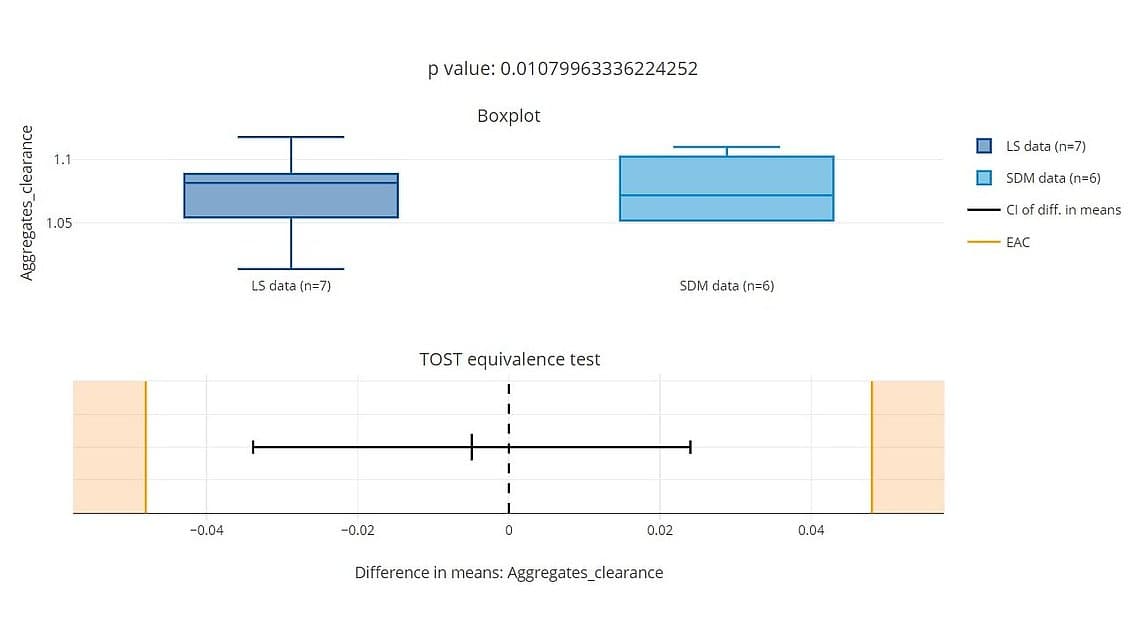
Hypothesentests liefern statistische Leitlinien für die Entscheidungsfindung. Auf diese Weise kann der mit einer Entscheidung verbundene Fehler kontrolliert oder minimiert werden. Die Fragen, die dabei gestellt werden, lauten in der Regel: Ist es sinnvoll anzunehmen, dass der Wert eines Populationsparameters gleich, größer oder kleiner als ein definierter Schwellenwert ist? Solche Tests können angewandt werden, um die Mittelwerte oder Varianzen von z. B. zwei Produktionsstätten zu vergleichen. Diese Tests bewerten in der Regel nur die statistische Signifikanz eines Ergebnisses, nicht aber die praktische Relevanz. Ein Unterschied in den Mittelwerten zweier Gruppen kann z. B. statistisch signifikant sein, aber nicht praktisch relevant. Äquivalenztests bieten eine einfache Lösung, mit der die Hypothese auf ihre praktische Relevanz geprüft werden kann (Limentani et al., 2005). Die Verwendung eines zweiseitigen t-Tests kann z. B. Aufschluss darüber geben, ob ein praktisch relevanter Unterschied zwischen zwei Produktionsstätten besteht.
Hauptkomponentenanalyse: Läuft mein Prozess konsistent?
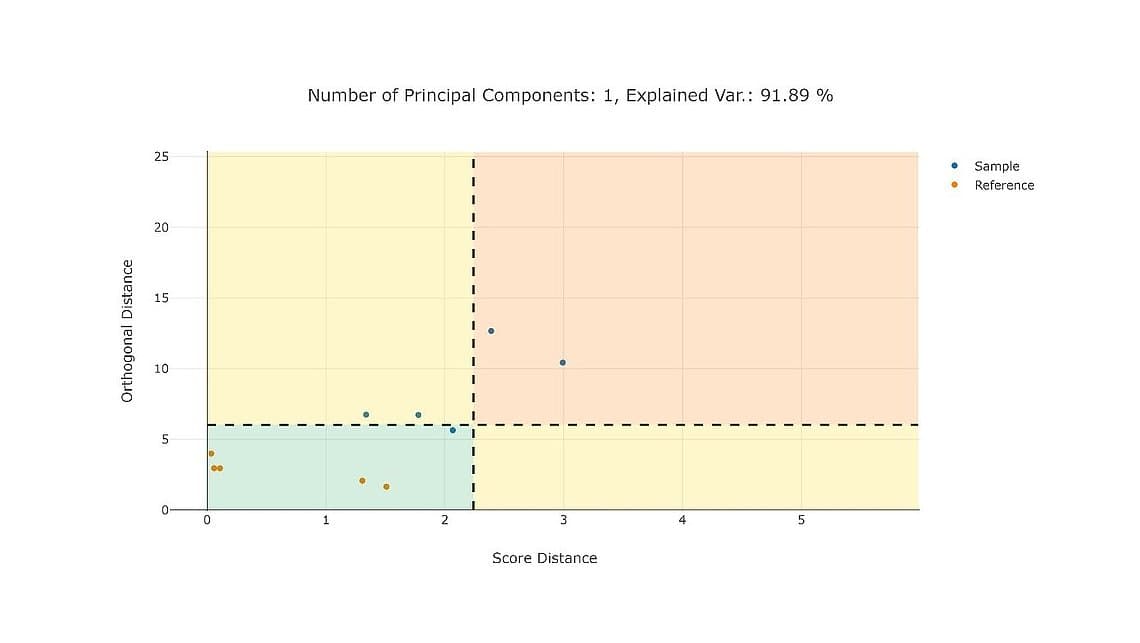
Diese Methode zur Dimensionsreduktion ermöglicht die Visualisierung von mehrdimensionalen Daten in einfachen Diagrammen. Fertigungskampagnen können anhand mehrerer skalarer Merkmale (z. B. Prozessparameter und Qualitätsmerkmale) verglichen werden. Es können mehrere zweidimensionale Diagramme erstellt werden. Sie unterscheiden sich durch die gewählte y- und x-Achse. Wenn die Hauptkomponenten als Achsen gewählt werden (Biplot), ermöglicht das Diagramm die Darstellung von Clustern innerhalb einer Gruppe von Produktionskampagnen. Eine weitere Alternative besteht darin, den Score-Abstand und den orthogonalen Abstand der einzelnen Kampagnen zum Modell als Achsen zu wählen. Dies ermöglicht die Identifizierung von abweichenden Kampagnen in einem multivariaten Raum.
Multivariate Regressionstechniken: Wie wirken sich meine Prozessparameter auf die Produktqualität aus?
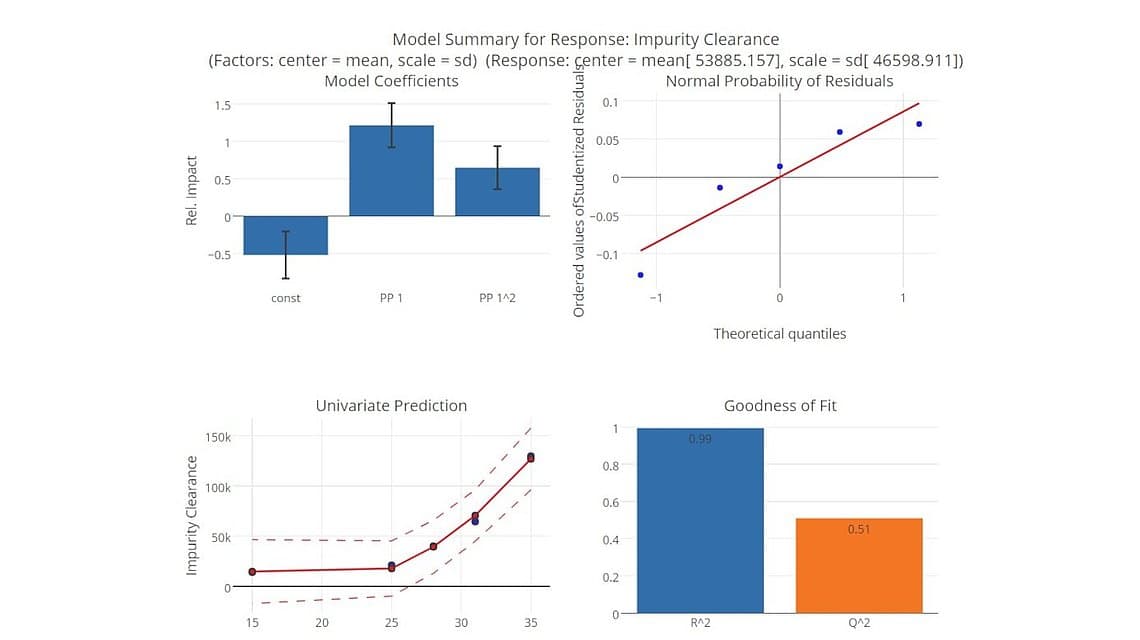
PAS-X Savvy unterstützt Sie mit benutzerfreundlichen Anwendungen bei der Durchführung statistischer Aufgaben entlang des Produktlebenszyklus.
Soft Sensors für die Informationsgewinnung
Soft-Sensoren machen das Beste aus Ihren Daten und Signalen, die Sie bereits gesammelt haben. Anstatt also immer mehr Hardware zu kaufen, helfen Ihnen Soft-Sensoren dabei, mehr Informationen über Ihr System zu erhalten, indem sie nur die Daten nutzen, die Sie bereits haben.
Zusammenfassung
Eine der kritischsten Fragen, die ein Prozessingenieur oder ein Prozessentwicklungsmanager beantworten muss, ist die Frage, wie er Datenmanagement, Visualisierungen und notwendige Statistiken realisieren kann. Eine Möglichkeit ist die Verwendung von Tabellenkalkulationen. Auch wenn dies nach einer schnellen Lösung klingt, werden Sie kurz- und langfristig auf große Schwierigkeiten stoßen. Erstens fehlt Ihnen die Möglichkeit, auf intelligente Weise nach Stapeln zu suchen und nach den Daten zu filtern, die Sie wirklich benötigen. Die Berechnungen sind zeitaufwändig und lassen sich nur selten von einem anderen Wissenschaftler oder zur Überprüfung durch das Management reproduzieren. Sie werden viel Zeit damit verbringen, Ihre Excel-Tabellen mithilfe von Formeln und Makros zu standardisieren, und am Ende sind sie wahrscheinlich inkonsistent. Langfristig werden Sie viel Zeit mit dem Kopieren und Einfügen von Daten in andere Tabellenblätter verlieren.
Eine zweite Möglichkeit besteht darin, Ihre Daten in einer zentralen Datenbank zu verwalten und sie mit Statistik- und Visualisierungssoftware zu verbinden. Verschiedene Datenquellen mit unterschiedlichen Datenmodellen und Datenformaten müssen von der Datenbank verarbeitet werden. Das Datenmodell wird sehr komplex sein, da Sie neben Zeitreihendaten und numerischen Merkmalen zusätzliche Informationen wie Laufnamen, Prozessphasen usw. speichern müssen. Darüber hinaus müssen alle Werkzeuge gewartet werden, und man findet sich schnell in einem kostspieligen Flickenteppich aus vielen verschiedenen Softwarekomponenten ohne die Möglichkeit einer direkten Datenbankintegration wieder.
Ideal ist der Einsatz einer zentralen Lösung wie PAS-X Savvy, die Datenmanagement, Visualisierung, Datenanalyse und Reporting an einem Ort vereint. Mit PAS-X Savvy automatisieren Sie Ihr Datenmanagement, die Visualisierung und die statistische Analyse für den Bioprozess-Lebenszyklus für Upstream-, Downstream- und Qualitätsdaten. Die weltweit führenden Pharma- und Biotech-Unternehmen vertrauen auf PAS-X Savvy - als Partner für Prozessingenieure - in F&E, Scale-up, Technologietransfer, Validierung und Produktion in mehr als 200 Installationen.
Nehmen Sie Kontakt mit uns auf, um weitere Informationen oder eine kostenlose Demo zu erhalten!
PAS-X Savvy - beschleunigen Sie Ihre Datenreise
Broschüre: Wie PAS-X Savvy die Verwaltung, Analyse und Berichterstattung Ihrer Pharma- und Biotech-Prozessdaten revolutioniert.
Das könnte Sie auch interessieren: