- Insights, Stories & Events
- Statistisches und mechanistisches Bioprozessmodell
Statistisches und mechanistisches Bioprozessmodell?
12 Minuten lesen
Tauchen Sie ein in die Welt der Bioprozessmodellierung und entdecken Sie, wie mechanistische und statistische Ansätze eine intelligentere Entwicklung, Echtzeitüberwachung und optimierte Fertigung vorantreiben.
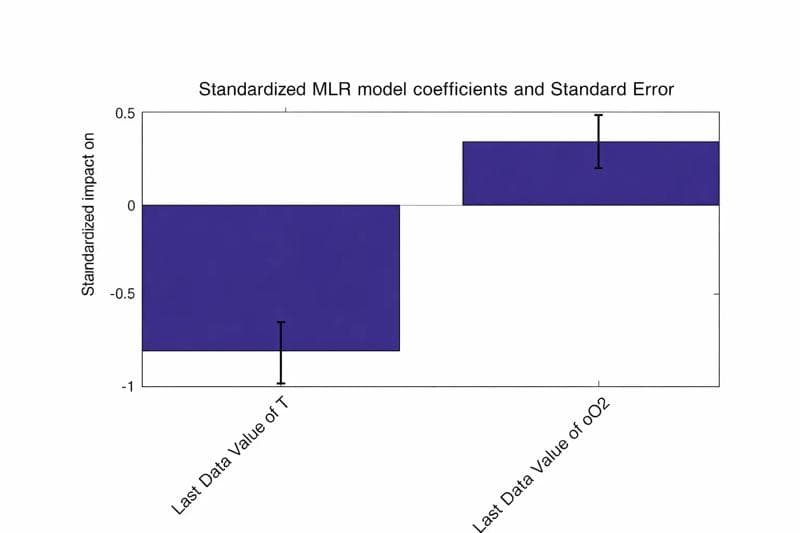
Highlights
- Was ist ein mechanistisches Bioprozessmodell?
- Wie unterscheiden sich mechanistische Bioprozessmodelle von einem statistischen (DoE-) Modell?
- Was sind industrierelevante Anwendungen für mechanistische Bioprozessmodelle?
- Computerumgebungen zur Entwicklung und Ausführung mechanistischer und statistischer Bioprozessmodelle?
Als Bioprozess-Experte hören und lesen Sie häufig von mechanistischen Bioprozessmodellen. Dennoch fragen Sie sich vielleicht, welche Relevanz mechanistische Modelle für Ihre Bioprozessentwicklungs- und Fertigungsaktivitäten haben.
In diesem Artikel erfahren Sie:
- Was ist ein mechanistisches Bioprozessmodell und wie unterscheidet es sich von einem statistischen (DoE-) Modell?
- Anwendungen mechanistischer Modelle in der Bioprozesstechnik?
- Computerumgebungen für Bioprozesse zur Entwicklung und Ausführung mechanistischer Modelle
Statistische (DoE) Modelle und mechanistische Bioprozessmodelle?
Bei der Prozessentwicklung und Prozesscharakterisierung geht es vor allem darum, die Beziehung zwischen (kritischen) Prozessparametern (CPPs) und kritischen Qualitätsmerkmalen (CQAs) sowie Leistungskennzahlen (Key Performance Indicators) zu untersuchen. Sie tun dies, um Prozessverständnis zu entwickeln. Sie müssen Prozessverständnis für Ihre Prozessvalidierung der Stufe 1 nachweisen, das Sie während Ihrer Prozesscharakterisierung- Studien entwickeln. Und natürlich, um Ihren zukünftigen Herstellungsprozess unter optimalen und robusten Produktionsbedingungen durchzuführen.
Es ist eine Best Practice der Industrie, für die Prozessentwicklung ein Toolset aus intelligenten Experimenten (Smart Experimentation), Bioprozess-Datenanalytik, und mathematischer Modellierung zu verwenden. Für die mathematische Modellierung gibt es zwei grundlegende Ansätze. Die statistische (DoE-basierte) Modellierung und die mechanistische Modellierung. Beide sind wichtig und haben ihre Anwendungsbereiche. Daher ist die Auswahl des richtigen Modellierungsansatzes für Ihre einzigartige Herausforderung in der Prozessentwicklung und Fertigung von entscheidender Bedeutung.
Was ist der grundlegende Unterschied zwischen mechanistischen und statistischen (DoE) Modellen?
Aber lassen Sie uns zunächst einen Blick auf die grundlegenden Unterschiede zwischen statistischer und mechanistischer Modellierung werfen. Im Allgemeinen geht es bei der Modellierung darum, die Beziehung zwischen Prozessparametern und Qualitäts- sowie Leistungsmerkmalen zu beschreiben. Typische statistische (DoE)-basierte Modelle beschreiben die Beziehungen auf folgende Weise:
Gleichung 1: Einfaches multilineares Regressionsmodell
CQA = K1+CPP1 + K2*CPP2 + α
- CQA ist ein kritisches Qualitätsmerkmal
- CPP ist ein kritischer Prozessparameter
- K1 und K2 sind Koeffizienten des multilinearen Regressionsmodells
- α ist der Y-Achsenabschnitt (Intercept)
Das Modell hier ist ein multilineares Regressionsmodell (MLR). Sie verwenden typischerweise MLR-Modelle gemäß dem DoE-Ansatz (Design of Experiments). Beachten Sie, dass die Koeffizienten K1, K2 keine biologische oder technische Bedeutung haben. Statistische Modelle zielen darauf ab, ein Modell zu finden, das die Daten am besten beschreibt.
Im Gegensatz dazu verwenden mechanistische Modelle mathematische Ausdrücke, die die biologischen oder technischen Prozesse am besten beschreiben. Zum Beispiel:
Gleichung 2: Differentialgleichung zur Beschreibung des mikrobiellen Wachstums in Batch-Kulturen.
dX/dt = µ *X
- X ist die Zellmassenkonzentration (g / L)
- t ist die Zeit (h)
- µ ist die spezifische Wachstumsrate der Mikroorganismen (h-1),
Gleichung 3: Monod-Gleichung, die mikrobielle Wachstumsraten in einer wässrigen Umgebung mit der Konzentration eines limitierenden Nährstoffs in Beziehung setzt.
Hier haben alle Ausdrücke im Modell eine biologische Bedeutung und können anhand der Literatur gegengeprüft werden.
µ = µmax*S/(Ks+S)
- μ ist die spezifische Wachstumsrate der Mikroorganismen
- μmax ist die maximale spezifische Wachstumsrate der Mikroorganismen
- S ist die Konzentration des limitierenden Substrats für das Wachstum
- Ks ist die „Halbgeschwindigkeitskonstante“ (Monod-Konstante) — der Wert von S, wenn μ/μmax = 0,5 ist
Zusammenfassend lässt sich der grundlegende Unterschied zwischen statistischen und mechanistischen Modellen wie folgt beschreiben:
Statistische Modelle verwenden mathematische Ausdrücke, um die Daten am besten zu beschreiben. Sie weisen Koeffizienten ohne technische Bedeutung auf. Mechanistische Modelle verwenden mathematische Ausdrücke, die den physikalischen oder biologischen Prozess am besten beschreiben. Die Koeffizienten haben eine technische Bedeutung und können sogar in der Literatur (oder durch unabhängige Messungen) überprüft (oder entnommen) werden.
Mechanistische Modelle haben (in der Theorie) so schöne Eigenschaften. Warum nutzen wir sie also nicht ständig in der industriellen Praxis?
In der Bioprozessentwicklung von Biologika ist eine der wichtigsten Aufgaben die Beschreibung der Beziehung zwischen (kritischen) Prozessparametern und (kritischen) Qualitäts- und Leistungsmerkmalen. Für Biologika-Prozesse müssen Sie bestimmen, wie sich Ihre Prozessparameter auf CQAs wie Glykosylierung, relative Wirksamkeit, Verunreinigungen, Aggregate und viele mehr auswirken.
Stellen Sie sich vor, Sie untersuchen, wie sich die Kultivierungstemperatur auf die Glykosylierung Ihres Arzneimittelprodukts auswirkt. Eine Temperaturänderung beeinflusst Tausende von Reaktionen innerhalb der Zelle. inige davon führen zu einer Änderung der Glykosylierung Ihres Produkts. Wie können Sie dies in der industriellen Praxis mithilfe mechanistischer Modelle angehen? Leider können Sie das (noch) praktisch nicht. Das System ist für unser derzeitiges Verständnis zu komplex. Weil wir das System nicht verstehen, müssen wir stattdessen statistische Modelle verwenden. Aus diesem Grund wird für die Untersuchung von CPP/CQA-Beziehungen der DoE-Ansatz mit anschließender statistischer Modellierung in der Industrie so weithin angewendet. Das ist auch der Grund, warum Statistik bei Bioprozesscharakterisierungen eine so wichtige Rolle spielt.
Es ist also eine Herausforderung, Änderungen bei CQAs mithilfe mechanistischer Modelle vorherzusagen. Aber wo können mechanistische Modelle für die Bioprozessentwicklung und -fertigung eingesetzt werden?
Soft-Sensoren (Software-Sensoren) für die Echtzeit-Bioprozessüberwachung
Mechanistische Modelle sind die Grundlage für industrielle Bioprozess-Softsensoren. Softsensoren werden verwendet, um Prozessvariablen (wie Biomassekonzentration, Lebendzelldichte, Glukose-, Laktatkonzentration usw.) in Echtzeit unter Verwendung eines mathematischen Modells vorherzusagen. Und in den meisten Fällen ist dieses Modell mechanistisch. Softsensoren für mikrobielle und Zellkulturprozesse sind verfügbar. Softsensoren werden in der Industrie eingesetzt, um (teure) Hardware-Sensoren zu ersetzen. Weitere Informationen zu Softsensoren finden Sie in unserem Artikel „Was ist ein Softsensor?“.
Simulation für Bioprozessdesign
Sie können mechanistische Modelle für das Design und die Optimierung von Bioprozessen anwenden. Produktbildung, Wachstum, Viabilität (Lebensfähigkeit) und Sauerstofftransferraten lassen sich mit mechanistischen Modellen gut simulieren. Beispielsweise können Sie in silico simulieren, wie sich Fütterungsprofile (Feeding Profiles) auf den Sauerstoffbedarf auswirken, wann Sie in eine Sauerstofflimitierung geraten würden und welches Fütterungsprofil optimal ist, um die Produktivität zu maximieren. Sie können auch simulieren, wie sich Ihr Prozess in Single-Use-Anlagen (Einweg-Anlagen) verhalten würde, wo Sie engere Stofftransportlimitierungen haben als bei Edelstahl. Dieser Ansatz wird ergänzend zum DoE-basierten Prozessdesign verwendet:
- Das anfängliche Prozessdesign wird mithilfe von Simulationen (mechanistischen Modellen) durchgeführt
- Die DoE-Methodik wird zur Verfeinerung und Untersuchung von CPP/CQA-Beziehungen verwendet
Prozesssteuerung zur Optimierung
Sie können das Modell in Echtzeit ausführen, um jede vom Modell geschätzte Variable zu steuern. Dies wird in der industriellen Biotechnologie angewendet. Dies bedeutet zudem, dass Sie eine Zielfunktion steuern können, wie z. B. den maximalen Titer oder die maximale Raum-Zeit-Ausbeute. Wenn Sie beispielsweise ein Maximum der Produktkonzentration erreichen wollen. Das Modell schätzt diese Konzentration, obwohl Sie sie gerade nicht tatsächlich messen. Nun können Sie beispielsweise im Zuge des Optimierungsverfahrens die Zufuhrrate eines limitierenden Substrats verändern, um die Produktkonzentration zu maximieren.
Computerumgebungen für Bioprozesse zur Entwicklung und Ausführung mathematischer Modelle?
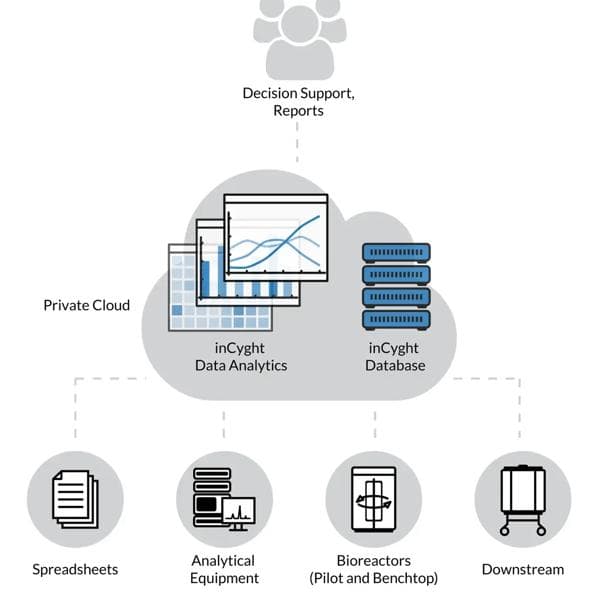
Um Bioprozessmodelle in Echtzeit auszuführen, benötigen Sie eine echtzeitfähige Computerumgebung. Mit der PAS-X Savvy Bioprozess Software entwickeln Bioprozesslabore und -hersteller modernste mechanistische und statistische Modelle sowie prädiktive Steuerungsalgorithmen.
Die PAS-X Savvy Echtzeitumgebung folgt einer Server/Client-Architektur. PAS-X Savvy wird auf einem zentralen Server für Datenmanagement und Echtzeitberechnungen ausgeführt. Dies ermöglicht Datenmanagement, Analytik und Echtzeit-Computing unter Verwendung aller historischen und Echtzeit-Daten. Verbindungen zu Laborgeräten werden über OPC- und ODBC-Schnittstellen hergestellt. Wissenschaftler greifen über den Webbrowser zur Prozessüberwachung zu, um mit der webbasierten R- und Python-IDE neue Modelle zu entwickeln. Anlagenbediener greifen per Remote-Zugriff oder im Labor zur Bioprozessüberwachung und Echtzeitanalytik zu.
Das könnte Sie auch interessieren: