- Insights, Stories & Events
- Biosimilarität und Bioäquivalenz
Biosimilarität: Wie lässt sich die Bioäquivalenz für Biosimilars statistisch nachweisen?
5 Minuten lesen
Erfahren Sie, wie statistische und multivariate Ansätze dabei helfen, die Biosimilarität in der Biosimilar-Entwicklung gemäß EMA-Richtlinien und Best Practices nachzuweisen.
Als Biotech-Unternehmen oder Qualitätslabor, das an der Entwicklung oder Herstellung von Biosimilars beteiligt ist, sind Sie dafür verantwortlich, die Bioäquivalenz/Biosimilarität Ihrer Biosimilars gegenüber den Originalprodukten (Originator) nachzuweisen. Insbesondere in frühen Stadien (Stammscreening, frühe Entwicklungsphase) ist der Nachweis der Bioäquivalenz/Biosimilarität ein wichtiges, aber viel diskutiertes Thema. Ein neues EMA-Papier zu Vergleichbarkeitstests liefert nun neue Erkenntnisse zu den aktuellen Best Practices. Dieser Artikel gibt einen Überblick über die wichtigsten Aspekte des neuen EMA-Papiers zu Vergleichbarkeitstests sowie regulatorische Dokumente und Richtlinien [1–3] in ihrer Relevanz für Bioäquivalenztests.
Was ist ein geeigneter statistischer Workflow zum Nachweis der Bioäquivalenz / Biosimilarität?
Hier fassen wir die wichtigsten Aspekte zusammen. Die Autoren des Diskussionspapiers (Reflection Paper) haben einen Workflow entwickelt, der sich in den folgenden Schritten zusammenfassen lässt:
- Allgemeines Ziel definieren
(Nicht-Unterlegenheit oder Äquivalenz) - CQAs definieren
(z. B. kontinuierlich, binär) - Maß der Ähnlichkeit definieren
(z. B. Differenz der Mittelwerte, Verhältnisse, multivariates Maß) - Experimentellen Studienplan und Probenahmestrategie unter Kontrolle der Messvariabilität durchführen
- Akzeptanzkriterien im Voraus festlegen und prüfen, ob der inferenzstatistische Ansatz durchgeführt werden kann
- Äquivalenz-/Nicht-Unterlegenheitstest durchführen
(z. B. TOST-Test) - Überlegungen zu falsch-positiven Schlussfolgerungen und Risikominderung bei Ergebnissen fehlender Vergleichbarkeit
Wie sollte ich beim Biosimilar-Screening vorgehen, um Biosimilarität zu erkennen?
Als Biosimilar-Entwickler müssen Sie zunächst nach einem Produktionsklon suchen, der ein dem Originalprodukt ähnliches Produkt herstellt. Typischerweise messen Sie mehrere kritische Qualitätsattribute des Produkts. Um kosteneffizient zu sein, vergleichen Sie in der Regel die Analyseergebnisse eines Stammes mit der Originator-Population. Es ist eine große Herausforderung, in dieser Situation Inferenzstatistik durchzuführen, da Sie nur eine Messung des Klons haben und daraus Schlussfolgerungen ziehen müssen. Dies entspricht dem EMA-Diskussionspapier, das besagt, dass Inferenzstatistik nicht immer machbar ist, insbesondere wenn Einzelwerte mit einer Population verglichen werden.
Speziell für Biosimilar-Screenings werden mehrere CQAs gemessen, die miteinander korrelieren. Daher ist es ratsam, multivariate Methoden anzuwenden, die eine höhere Power haben, um Ähnlichkeiten und potenzielle Unterschiede zu erkennen.
Multivariate Biosimilaritätsanalyse für das Biosimilar-Screening
Qualitätsexperten verwenden die Werum PAS-X Savvy Software für das Qualitätsdatenmanagement und die Datenanalyse von Biologika. Für den Fall des Biosimilar-Screenings hat Körber zusammen mit Vela Laboratories einen leistungsstarken Ansatz entwickelt, um multivariate Ähnlichkeiten von individuell getesteten Klonen/Prozessbedingungen nachzuweisen. Er funktioniert auf folgende Weise:
- Auswahl der Originator-Gruppe: zu vergleichende Klone/Prozessbedingungen & Variablen, die zur Bewertung der Ähnlichkeit verwendet werden sollen
- Als Ergebnis können Biosimilar-Klonkandidaten/Prozessbedingungen kategorisiert werden in:
- Ähnlich mit einer gewissen Konfidenz (alle Biosimilar-Chargen im grünen Bereich des untenstehenden Beispiels)
- Ähnlich, aber mit einer anderen Korrelation zwischen den Analysemethoden, wie die Biosimilar-Chargen 4 und 5 im untenstehenden Beispiel (diese könnten z. B. durch Inkonsistenzen zwischen den Ergebnissen redundanter Methoden verursacht werden)
- Extremes/abweichendes Verhalten gegenüber dem Originator zeigend, wie Biosimilar-Charge 7 im untenstehenden Beispiel - Variablen werden von der App identifiziert, die zu inkonsistentem oder extremem Verhalten von Biosimilar-Chargen führen. An diesem Punkt können Gegenmaßnahmen ergriffen werden, entweder durch Nachmessung einer Probe oder durch Einstufung von Klonen/Prozessbedingungen als ähnlich oder unterschiedlich. Infolgedessen können die ähnlichsten Klone/Prozessbedingungen identifiziert werden.
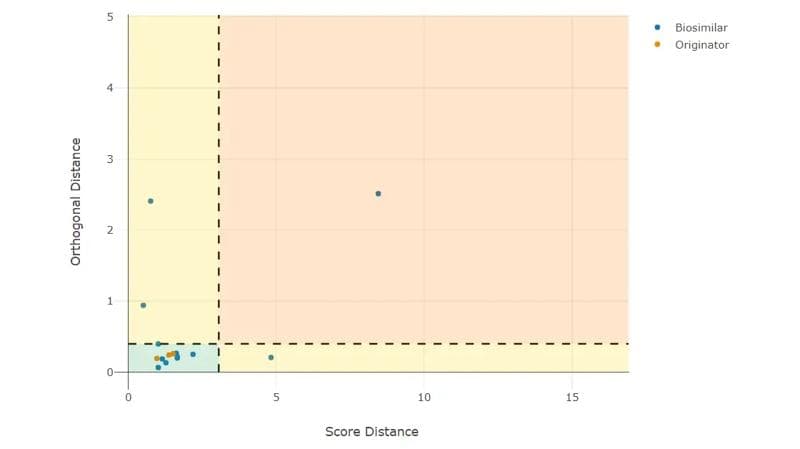
Outlier-Plot, der Biosimilar- und Originator-Chargen mit ihren zugehörigen multivariaten Scores und orthogonalen Distanzen zeigt. Zusätzlich sind auch die 97,5 %-Toleranzintervalle als schwarze gestrichelte Linien eingezeichnet. Die Score-Distanz von Proben dient als Maß für die Biosimilarität zur Originator-Gruppe. Chargen im grünen Bereich können als dem Originator ähnlich betrachtet werden.
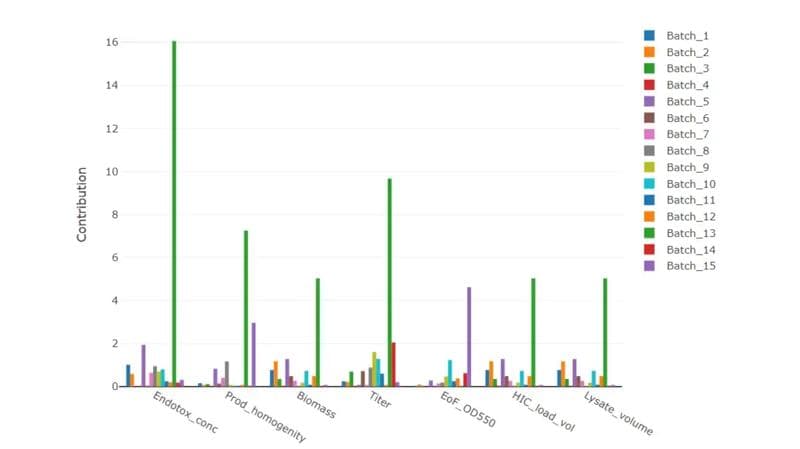
Contribution-Plots zeigen, welche Variablen am stärksten zur Differenz des Biosimilars zur Originator-Gruppe beitragen. Insbesondere Charge 13 zeigt Unterschiede in der Endotoxinkonzentration (Endotox_conc) und im Titer.
Die Lösung ist als Plug-in für die PAS-X Savvy Datenmanagement- und Analysesoftware verfügbar der Supply Chain vermeiden. Für weitere Informationen kontaktieren Sie uns und sprechen Sie mit einem unserer Data Scientists.
PAS-X Savvy für GMP-Qualitätslabore: Bioäquivalenzprüfung
Als führender Analytik-Dienstleister und Biotech-Labor im Bereich Biosimilars unterstützen wir viele Kundenprojekte beim Screening von Biosimilar-Klonen sowie bei Vergleichbarkeitsstudien. Unsere Kunden müssen die richtigen Klone mit minimalem analytischem Aufwand und hochkonsistenten Daten auswählen. Mit der PAS-X Savvy® Software haben wir nun ein Tool in der Hand, um zu untersuchen, welche Klone oder Prozessbedingungen sich am ähnlichsten zum Originator-Produkt verhalten. Darüber hinaus können wir untersuchen, welche Prozessparameter und Einstellungen den höchsten Biosimilarity Score erreichen.
Lernen Sie unsere Autoren kennen
Thomas Zahel
Head of CMC Innovation Consulting
Thomas Zahel ist Head of CMC Innovation Consulting bei Körber. Er hat einen Master-Abschluss in biochemischem Ingenieurwesen von der Technischen Universität Graz und einen Doktortitel in angewandter Statistik von der Technischen Universität Wien. Er verfügt über Expertenwissen in Theorie und Implementierung einer Vielzahl statistischer Disziplinen und langjährige Erfahrung in der Entwicklung statistischer Workflows für die Prozesscharakterisierung.
Das könnte Sie auch interessieren: